IAFil d’actu, 10 nov. 2026
Claude Fable 5.2 : deux démonstrations d'Anthropic, pas encore vérifiées par des tiers
Rapporté par Frandroid, Numerama
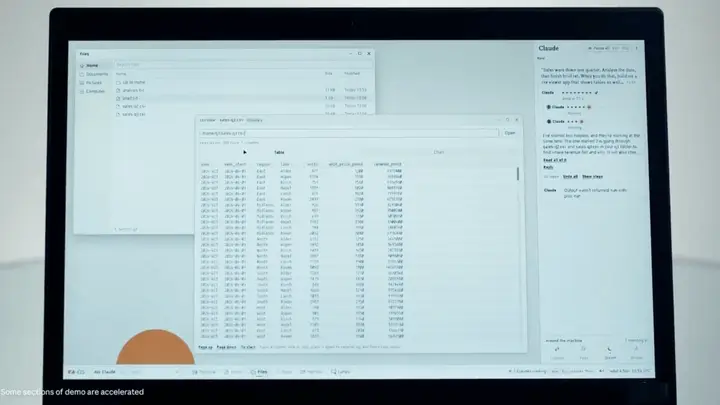
Anthropic a lancé Claude Fable 5.2 le 9 novembre, avec une baisse de 20 % de ses prix. Pour présenter le modèle, l'entreprise met en avant deux démonstrations : un système d'exploitation écrit par son IA et la formalisation d'une preuve mathématique célèbre. Ces exemples viennent de l'annonce officielle. À ce stade, aucun n'a été vérifié de l'extérieur.
Selon Anthropic, un ingénieur a confié à Fable 5.2 la conception d'un prototype de système d'exploitation, en partant d'un dossier vide. Le modèle aurait coordonné plus de 1 000 sous-agents, c'est-à-dire des copies de lui-même qui se partagent l'écriture, les tests et la relecture du code. Au bout de huit jours, le résultat démarre un ordinateur portable. D'après Frandroid, il comprend un noyau, des pilotes pour le disque, le clavier et le réseau, un stockage permanent, un gestionnaire de fenêtres, un écran de connexion, un installateur et l'assistant Claude intégré.
Anthropic ne précise ni le nom de ce système, ni le langage utilisé, ni le nombre de lignes de code, ni le coût de l'expérience. Le code n'est pas publié. Frandroid note qu'on ne sait pas si l'ingénieur est intervenu pendant le travail, ni combien d'essais ont échoué avant le résultat final. La démonstration s'adresse surtout aux développeurs et aux entreprises qui confient de longs projets à des équipes d'agents, un rôle d'orchestrateur que l'entreprise met en avant pour Fable 5.2. Frandroid rappelle qu'en février, Anthropic avait décrit plus en détail un compilateur C écrit par 16 agents Claude Opus 4.6. Ce travail avait duré deux semaines, coûté environ 20 000 dollars de calcul et produit 100 000 lignes de Rust.
Numerama décrit une autre démonstration, présentée dans le même lancement. Près de 1 000 agents ont formalisé en 30 heures la preuve du dernier théorème de Fermat dans Lean, un assistant de preuve qui vérifie chaque étape. Le théorème avait déjà été démontré par Andrew Wiles en 1995. Il ne s'agit donc pas d'une nouvelle preuve, mais de la mise en forme d'une preuve existante, que l'ordinateur peut contrôler ligne à ligne.
Les agents ne partaient pas de rien. Ils disposaient de 60 énoncés à démontrer, de 47 résultats déjà prouvés lors d'une précédente formalisation d'Anthropic et de la bibliothèque mathématique Mathlib. Pour se coordonner, ils utilisaient un dépôt Git et une base de données. Un responsable répartissait le travail entre des équipes de 16 ou 17 assistants, chacune dirigée par un capitaine. Le dernier théorème est tombé après 28,7 heures. Les ingénieurs ont relancé l'expérience après 18 heures, à partir de la dernière sauvegarde. Numerama souligne aussi que, avec le même dispositif, Claude Opus 5.5 n'a bouclé que 26 % du travail en 18 heures. Ce résultat vient d'une seule exécution interne, qui n'a pas encore été reproduite.
Du côté du modèle, Fable 5.2 succède à Fable 5.1, sorti en septembre. Il repose sur la même base que Claude Mythos 5.2. La version Fable intègre des garde-fous en cybersécurité et en biologie, ce qui permet de l'ouvrir à tous. Mythos reste réservé aux organisations vérifiées. Selon les premiers tests d'Anthropic, ces filtres déclenchent environ 55 % de blocages en moins qu'avec Fable 5.1, pour une protection équivalente d'après l'entreprise. Le modèle répond jusqu'à 30 % plus vite. Par API, il coûte 8 dollars par million de tokens en entrée et 40 en sortie, contre 10 et 50 dollars pour Fable 5.1. Anthropic recommande toutefois Opus 5.5 pour la plupart des tâches, Fable 5.2 étant réservé aux projets les plus exigeants.
Les résultats annoncés par l'entreprise sont les suivants. Sur FrontierCode 2.0, un test qui mesure si des modifications de code seraient acceptées par les responsables de projets open source, Fable 5.2 obtient 49,1 %. Opus 5.5 atteint 45,5 %, GPT-6 Astra d'OpenAI 42,8 % et Fable 5.1 32,4 %. Sur Humanity's Last Exam, qui rassemble des questions de niveau expert, le score avec outils atteint 74,2 %, contre 67,7 % pour Opus 5.5, 65,6 % pour Fable 5.1 et 57,2 % pour GPT-6 Astra. Ces chiffres viennent d'Anthropic, sont obtenus au niveau de réflexion le plus élevé et dépendent des conditions de test.
Plusieurs points restent inconnus. Il faudrait voir le code du système d'exploitation, la consommation réelle de tokens et l'avis de développeurs indépendants. Anthropic affirme aussi que Fable 5.2 a conçu trois appareils électroniques fonctionnels et résolu deux problèmes ouverts de physique des trous noirs. Ces travaux sont décrits dans des prépublications qui n'ont pas encore été relues par des pairs. Pour l'instant, il faut donc lire ces démonstrations comme des affirmations de l'entreprise, en attendant des vérifications indépendantes.
Vous aimez ? La newsletter IA
Chaque jeudi : l’IA qui compte pour votre maison.
✓ Gratuit · sept éditions · désinscription en un clic
Comment chaque source en parle
Reportage original des sources ci-dessus. Résumé par smart-home.space.